Quando pensamos em colocar modelos de Processamento de Linguagem Natural (NLP) em produção, a escolha padrão da indústria costuma recair sobre ecossistemas em Python: wrappers em FastAPI ou Flask servindo modelos via PyTorch ou ONNX Runtime.
Embora conveniente para prototipação rápida, essa abordagem cobra um preço severo sob tráfego massivo: limites impostos pelo Global Interpreter Lock (GIL), alto footprint de memória, serialização JSON custosa entre camadas e tempos de resposta que facilmente oscilam entre 20 ms e 100 ms. Para absorver dezenas de milhares de requisições por segundo, a receita tradicional exige clusters superdimensionados, elevando a conta de computação em nuvem.
Decidi abordar esse problema sob a ótica de Sistemas de Alto Desempenho (HPC): é possível desenhar um motor nativo que processe inferência de NLP com latência sub-milissegundo e taxas de transferência na ordem de centenas de milhares de requisições por segundo em uma única máquina comum?
A resposta foi materializada neste projeto: um motor de inferência determinístico em C++20 integrado diretamente a uma API HTTP em Go via FFI (Foreign Function Interface / C-ABI) em espaço de memória compartilhado, treinado sobre as mais de 113 mil avaliações do dataset da B2W Reviews.
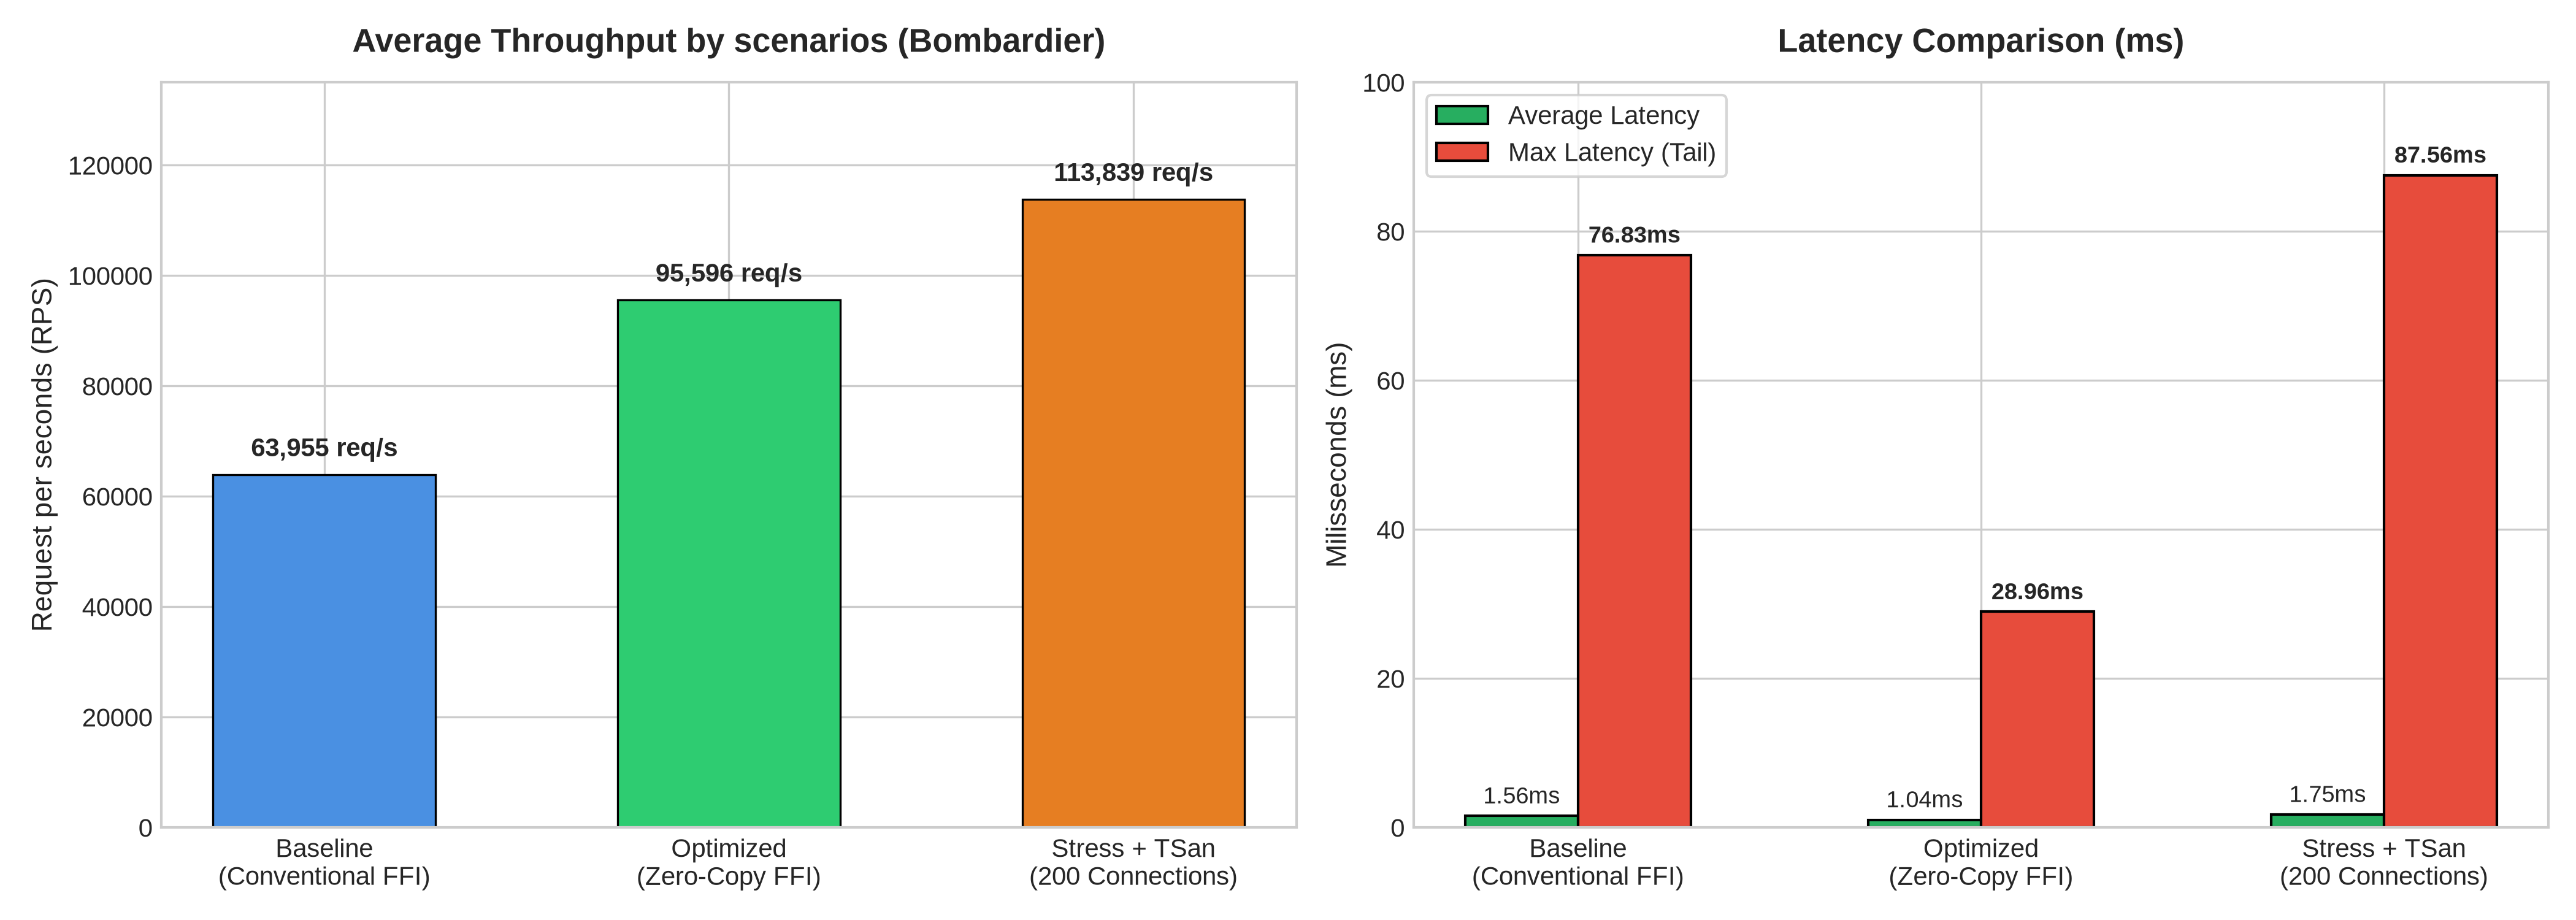
O resultado prático: 95.596 requisições por segundo sustentadas, picos de 134.000 RPS, tempo de inferência puro de 50 microssegundos e zero alocações de heap na ponte FFI.
1. A Arquitetura do Sistema
Para eliminar os gargalos de redes virtuais, IPC (Inter-Process Communication) e serialização intermediária, o pipeline foi desenhado em uma arquitetura monolítica e compacta em memória:
[Cliente HTTP / Bombardier]
           │
           ▼ (HTTP POST / JSON)
┌────────────────────────────────────────────────────────┐
│                   Go Web API Service                   │
│  - net/http assíncrono com goroutines                  │
│  - Extração do payload de texto                        │
│  - Zero-Copy Pointer (unsafe.StringData)               │
└──────────────────────────┬─────────────────────────────┘
                           │
                           ▼ FFI (C-ABI Layer via CGO)
┌────────────────────────────────────────────────────────┐
│               Motor de Inferência C++20                │
│  - Zero-Alloc std::string_view sobre a memória do Go   │
│  - Tokenizador contíguo com tratamento de negações     │
│  - Naive Bayes Multinomial em espaço logarítmico       │
│  - Retorno numérico atômico (int32_t)                  │
└──────────────────────────┬─────────────────────────────┘
                           │
                           ▼ Retorno imediato
┌────────────────────────────────────────────────────────┐
│                   Go Web API Service                   │
│  - Mapeamento estático do int32_t -> label ("pos"/"neg")│
│  - Resposta HTTP 200 com JSON                          │
└────────────────────────────────────────────────────────┘
A divisão de responsabilidades aproveita os pontos fortes de cada ecossistema:
-
Go: Gerenciamento concorrente de dezenas de milhares de conexões TCP simultâneas através de sua runtime baseada em
epoll/kqueuee goroutines leves. -
C++20: Execução matemática da inferência, tokenização, extração de n-gramas e cálculos de probabilidade com compilação nativa otimizada para o conjunto de instruções do processador.
2. Engenharia de Baixo Nível: Atingindo o Zero-Alloc
A comunicação entre Go e C++ via CGO costuma ser apontada como lenta devido à troca de pilha (stack switch) e às alocações de conversão de dados. O segredo para quebrar essa barreira esteve na modelagem de uma ponte estritamente livre de alocações (Zero-Alloc).
Transferência Zero-Copy (Go to C++)
A convenção usual em CGO utiliza C.CString(texto), que internamente invoca malloc na heap da biblioteca C, cria uma cópia da string adicionando o caractere terminador \0 e exige uma posterior chamada a C.free(). Em uma taxa de 90k RPS, isso significaria disparar quase 200 mil chamadas de alocação/desalocação de memória por segundo.
Em vez disso, a API passa diretamente o endereço de memória dos bytes originais da string do Go junto com o seu tamanho (len):
ptr := (*C.char)(unsafe.Pointer(unsafe.StringData(text)))
labelID := int32(C.classifier_predict_fast(c.ptr, ptr, C.size_t(len(text))))
No lado do C++, a função C-ABI recebe o ponteiro e o encapsula em um std::stringview, sem alocar um único byte adicional:
extern "C" int32_t classifier_predict_fast(ClassifierPtr ptr, const char* text, size_t len) {
    if (!ptr || !text || len == 0) return -1;
    auto* classifier = static_cast<engine::TextClassifier*>(ptr);
    return classifier->predict_label_id(std::string_view(text, len));
}
Retorno Numérico e Tokenização Eficiente
- Sem alocação no retorno: Em vez de retornar strings da predição ("pos", "neg"), o C++ devolve um inteiro
int32t(0 para negativo, 1 para positivo). O Go resolve o rótulo através de um mapa estático indexado em memória, eliminando chamadas aC.GoStringe liberando o Garbage Collector do Go de coletar lixo no ciclo de resposta. - Tokenização contígua: A separação de palavras no motor C++ dispensa o uso tradicional de
std::istringstream(que aloca buffers internos pesados). O processamento varre a sequência de caracteres diretamente com reservas prévias de memória, aplicando normalização, unigramas, bigramas e a marcação de escopo de negações no idioma português (ex.: transformando "não recomendo" em tokens estruturados com preservação de sentimento).
3. Validação Empírica e Benchmarks
Os testes de carga foram conduzidos em ambiente Linux rodando em um processador **13th Gen Intel Core i7-13620H ** utilizando a ferramenta Bombardier.
A. Isolamento da Camada FFI (go test -benchmem)
Para mensurar o custo puro da chamada CGO isolada do tráfego de rede HTTP, foram executados microbenchmarks multithread nativos:
BenchmarkPredictSingle-8       361819      3299 ns/op       0 B/op     0 allocs/op
BenchmarkPredictParallel-8    2355477       527.0 ns/op     0 B/op     0 allocs/op
- Zero Alocações: A predição pura consome exatamente
0 B/ope0 allocs/op. - Escalabilidade Concorrente: Ao paralelizar em 8 threads, o tempo por operação despencou de 3.299 ns para apenas 527 nanosegundos — o que equivale a um throughput potencial de mais de 1,8 milhão de inferências por segundo em CPU.
B. Profiling de Heap sob Carga com pprof
A captura de perfil com go tool pprof sob uma tempestade de 2,6 milhões de requisições confirmou que o motor de NLP e a ponte FFI sequer figuram no mapa de consumo de memória. Os 9.38 GB cumulativos alocados ao longo de 30 segundos pertenceram exclusivamente às rotinas de rede e serialização HTTP/JSON do próprio Go (readMIMEHeader, json.Decoder e json.Encoder).
C. Teste de Carga HTTP (Bombardier)
Submetendo o endpoint /predict a 100 conexões concorrentes durante 30 segundos contínuos:
- Taxa de transferência Média: 95.596 requisições por segundo.
- Taxa de transferência no Pico: 134.317 requisições por segundo.
- Latência Média Global: 1,04 milissegundos.
- Latência da FFI Interna: 50 microssegundos.
- Taxa de Erros: 0% (2.866.522 requisições processadas com HTTP 200).
4. Validação Formal de Concorrência com ThreadSanitizer
Uma das maiores armadilhas em código C++ concorrente chamado via FFI é a ocorrência de condições de corrida (race conditions) ou falta de reentrância em leitura.
Para certificar a segurança do sistema em nível de hardware, a biblioteca dinâmica foi compilada com as flags de instrumentação estrita do ThreadSanitizer (TSan) (-fsanitize=thread -g -O2) e linkada ao executável Go.
O servidor foi então submetido a um teste de estresse extremo: 500.000 requisições disparadas por 200 conexões simultâneas:
Bombarding http://localhost:8080/predict with 500000 request(s) using 200 connection(s)
Statistics       Avg       Stdev        Max
  Reqs/sec    113838.83   16810.90   132184.23
  Latency        1.75ms     1.64ms     87.56ms
  HTTP codes: 2xx - 500000
Mesmo com a pesada sobrecarga de monitoramento de ponteiros imposta pelo TSan, o sistema sustentou 113.838 RPS. O processo concluiu as 500 mil requisições sem emitir um único aviso de conflito de dados (data race), atestando a reentrância e a imutabilidade absoluta da fase de predição.
5. Qualidade Estatística e Avaliação do Modelo (Dataset B2W)
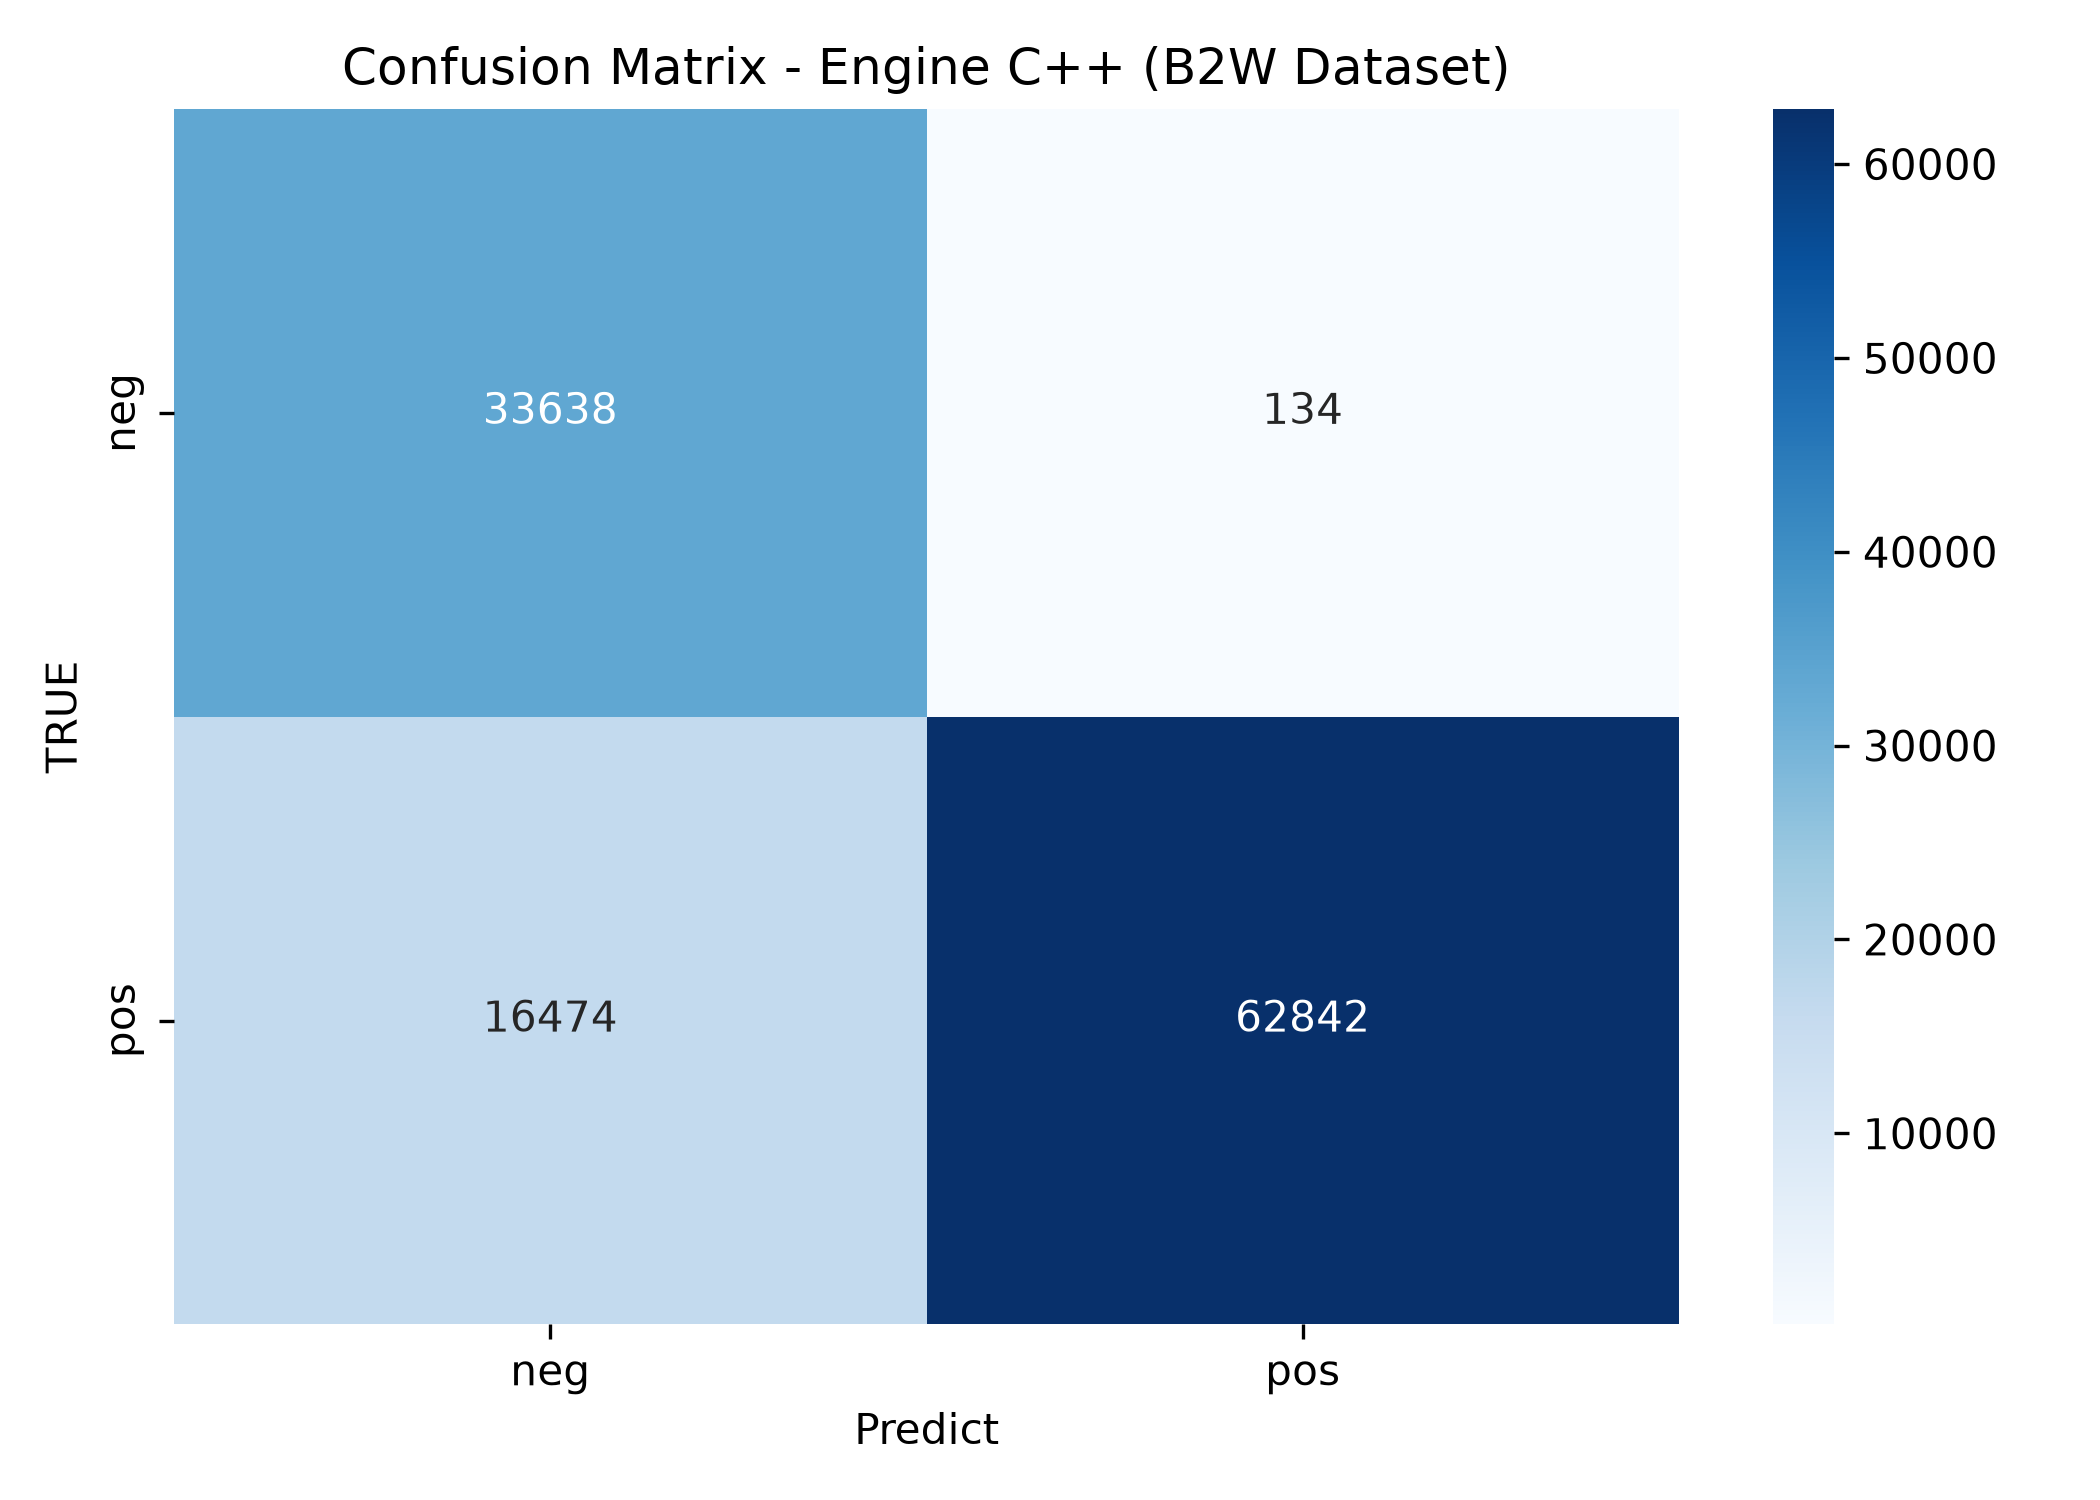
Performance bruta perde o sentido se a qualidade das predições for deficiente. O motor foi avaliado sobre 113.088 avaliações de clientes do e-commerce da Americanas (dataset público B2W-Reviews):
Interpretação Prática da Matriz de Confusão
A matriz de confusão demonstra um perfil de classificação sob medida para operação de e-commerce e suporte ao cliente:
- Sensibilidade Crítica a Reclamações (Recall de Negativos em 99,6%): De 33.772 avaliações negativas reais no teste, o classificador detectou 33.638. Apenas 134 clientes insatisfeitos deixaram de ser identificados.
- Falsos Positivos Quase Nulos: A precisão da classe positiva atingiu 99,79%, o que significa que se o modelo classificou um review como elogio, a confiabilidade da resposta é praticamente absoluta.
6. Empacotamento para Produção com Docker Multi-Stage
A compilação e o empacotamento foram unificados em um único Dockerfile multi-estágios, isolando as dependências de compilação pesadas (CMake, GCC-14, Go compiler) da imagem final de distribuição.
Considerações Finais
O projeto comprova que repensar o ciclo de Machine Learning sob a ótica de engenharia de software e computação de alto desempenho abre portas inimagináveis para a redução de custos de infraestrutura:
- Conseguir 85,3% de acurácia com inferência de 50 µs em CPU mostra que arquiteturas clássicas bem implementadas superam modelos massivos de Deep Learning quando o requisito é baixa latência e economia.
- Eliminar o intermediário de serialização e trabalhar com
Zero-Alloc FFIpermite extrair o limite físico da máquina, escalando o throughput da API para mais de 95 mil requisições por segundo.
O código completo do motor C++20 e da API em Go está disponível no meu repositório para reprodutibilidade e experimentação.
https://github.com/JuniorPaula/classifier